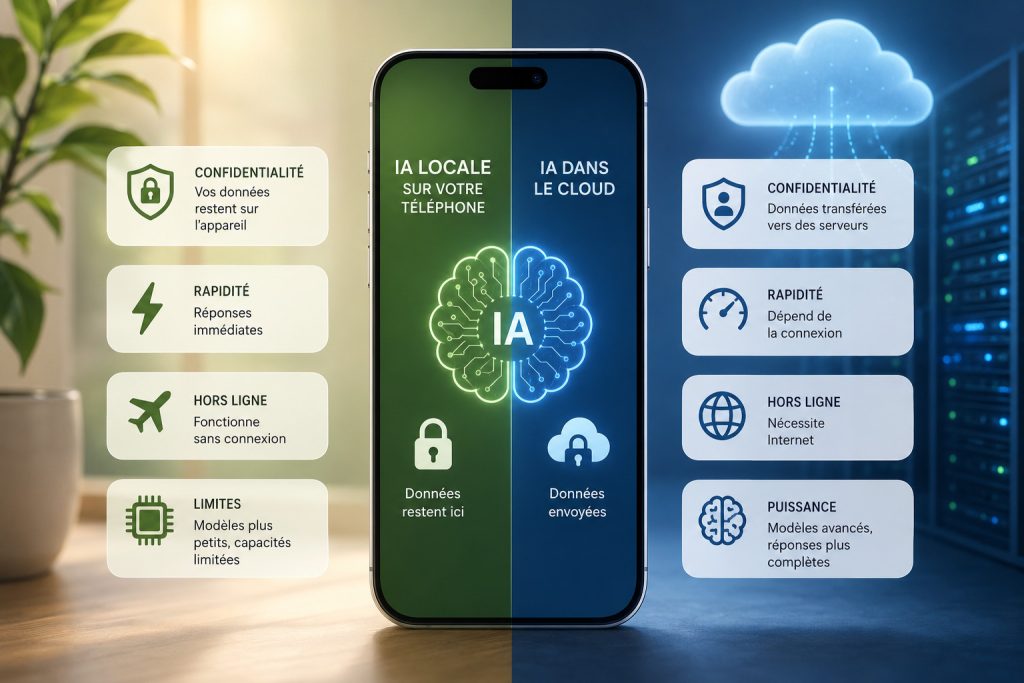
Une intelligence artificielle capable de résumer des messages, de corriger un texte ou d’analyser des photos sans les envoyer sur Internet semble naturellement plus respectueuse de la vie privée qu’un service hébergé dans le cloud.
L’intuition est globalement juste. Lorsqu’un modèle fonctionne réellement sur le téléphone, les données peuvent rester confinées dans l’appareil. Elles ne transitent pas vers les serveurs du fournisseur, ne dépendent pas de sa politique de conservation et peuvent être traitées sans connexion Internet.
Mais cette protection n’est ni automatique ni absolue.
Une application peut utiliser un modèle local tout en transmettant des données d’usage, en synchronisant certains résultats ou en basculant vers un modèle distant lorsque la tâche devient trop complexe. Inversement, un service cloud correctement conçu peut limiter fortement la conservation des requêtes et utiliser des architectures destinées à empêcher l’opérateur d’accéder à leur contenu.
La réponse raisonnable est donc la suivante : une IA locale offre généralement une meilleure base de confidentialité, mais elle ne protège réellement la vie privée que si l’ensemble de l’application respecte cette logique.
Que signifie exactement « une IA installée sur le téléphone » ?
Dans un système local, également appelé IA embarquée ou on-device AI, le modèle est stocké sur le téléphone et les calculs nécessaires à la production de la réponse sont exécutés par son processeur, son circuit graphique ou une puce spécialisée.
Le texte, l’image ou l’enregistrement audio analysé n’a alors pas besoin d’être envoyé à un serveur distant. Android présente par exemple Gemini Nano comme un modèle capable d’exécuter certaines tâches sans connexion réseau ni envoi de données dans le cloud. Son service AICore est conçu pour traiter localement les requêtes et ne pas conserver les entrées et les sorties après leur exécution.
Apple propose une logique comparable pour plusieurs fonctions de son système d’intelligence personnelle. Les résumés de courriels, de messages ou de notifications peuvent notamment être produits par des modèles exécutés directement sur l’appareil. Lorsque la puissance du téléphone ne suffit plus, certaines requêtes peuvent toutefois être envoyées vers son infrastructure Private Cloud Compute.
Le terme « IA sur le téléphone » peut donc désigner trois architectures différentes :
- un traitement entièrement local ;
- un traitement local avec certaines fonctions cloud ;
- un système hybride qui choisit dynamiquement entre le téléphone et un serveur.
Cette distinction doit être vérifiée fonction par fonction. Une application n’est pas « locale » simplement parce qu’une partie de son intelligence fonctionne sur l’appareil.
Pourquoi le traitement local protège généralement mieux les données
Le premier avantage est la réduction des transferts.
Lorsqu’un utilisateur demande à une IA locale de résumer un échange confidentiel, le contenu peut rester sur son téléphone. Il n’est pas nécessaire de transmettre la conversation, l’identité des participants ou les documents joints à un prestataire extérieur.
Cette architecture réduit plusieurs catégories de risques : interception lors du transfert, mauvaise configuration d’un serveur, fuite provenant d’un sous-traitant, conservation excessive des requêtes ou réutilisation des données pour améliorer un service.
Elle limite également le nombre d’acteurs auxquels l’utilisateur doit faire confiance. Avec une IA cloud, la confidentialité dépend du fournisseur, de son hébergeur, de ses sous-traitants, de ses procédures internes et des juridictions dans lesquelles les données sont traitées. Avec une exécution locale, la frontière principale se rapproche de l’appareil et de son système d’exploitation.
Le bénéfice est particulièrement important pour les données très personnelles : messages privés, photos, notes, documents professionnels, informations médicales ou enregistrements vocaux.
Une IA locale peut en outre personnaliser ses réponses à partir d’informations présentes sur le téléphone sans nécessairement constituer un profil centralisé sur les serveurs d’une entreprise. Elle peut, par exemple, exploiter un calendrier ou un carnet d’adresses uniquement pendant l’exécution de la tâche.
Cela ne rend pas l’utilisation sans risque, mais applique un principe de sécurité fondamental : une donnée qui n’est jamais transmise ne peut pas être compromise par le serveur qui ne la reçoit pas.
« Local » ne signifie pourtant pas « aucune donnée ne sort »
Le modèle et l’application qui l’utilise sont deux composants différents.
Le modèle peut fonctionner localement tandis que l’application transmet des statistiques d’utilisation, des rapports d’erreur, des identifiants publicitaires ou des informations sur les fonctions activées. Ces métadonnées ne contiennent pas nécessairement le texte exact des requêtes, mais elles peuvent révéler les habitudes, les horaires, le type de documents traité ou la fréquence d’utilisation.
L’application peut également enregistrer les entrées avant de les transmettre au modèle local, puis synchroniser l’historique sur un compte cloud. L’exécution locale n’empêche techniquement pas son éditeur d’ajouter d’autres mécanismes de collecte.
Certains systèmes adoptent par ailleurs une architecture hybride. Google propose depuis 2026 une interface expérimentale permettant à une application Android de privilégier le modèle local, puis de se rabattre sur le cloud lorsqu’il n’est pas disponible. Le mécanisme inverse est également prévu lorsque la connexion disparaît.
Ce fonctionnement peut être utile, mais il rend le discours marketing ambigu. L’utilisateur peut croire qu’une fonction est privée parce qu’elle porte la mention « IA sur l’appareil », alors qu’une partie des demandes est susceptible de quitter le téléphone selon le modèle disponible, la complexité de la tâche ou la configuration choisie par le développeur.
Une politique sérieuse devrait donc indiquer clairement :
- quelles opérations sont entièrement locales ;
- quelles opérations nécessitent le cloud ;
- quelles données sont alors envoyées ;
- si le basculement est automatique ;
- si l’utilisateur peut le désactiver.
Sans ces informations, la promesse de confidentialité reste difficilement vérifiable.
Le téléphone lui-même devient le point sensible
Le traitement local déplace le risque plutôt qu’il ne le supprime.
Si les messages, les documents et les résultats restent sur le téléphone, la sécurité dépend davantage de la protection du terminal. Un appareil volé, infecté ou déverrouillé peut exposer des informations qui n’auraient jamais quitté son stockage.
Le chiffrement du téléphone, le verrouillage automatique, les mises à jour du système et une méthode d’authentification solide restent donc indispensables. La CNIL recommande notamment d’activer le verrouillage du terminal, de limiter les données stockées localement au strict nécessaire et de prévoir des mécanismes permettant de réduire les conséquences d’une perte ou d’un vol.
Les sauvegardes constituent un autre angle mort. Une donnée traitée localement peut ensuite être incluse dans une sauvegarde distante, synchronisée entre plusieurs appareils ou copiée dans une autre application. Affirmer qu’elle « ne quitte jamais le téléphone » exige donc d’examiner tout son cycle de vie, pas seulement les quelques secondes pendant lesquelles le modèle produit sa réponse.
Enfin, une application malveillante disposant de permissions excessives pourrait accéder à des fichiers, au presse-papiers, au microphone ou aux notifications. Le caractère local du modèle ne protège pas contre un logiciel déjà autorisé à consulter les mêmes informations.
L’IA locale est-elle plus rapide ?
Elle peut l’être, mais pas systématiquement.
Le traitement local supprime le temps nécessaire pour envoyer la requête au serveur et recevoir la réponse. Pour une tâche courte — reformuler une phrase, classer une notification, transcrire quelques secondes d’audio — cette absence de latence réseau peut rendre le résultat presque immédiat. Google souligne cependant que la vitesse réelle dépend directement du matériel du téléphone.
Pour une demande longue ou complexe, un serveur peut au contraire être plus rapide. Les centres de données disposent de processeurs spécialisés, de davantage de mémoire et de modèles beaucoup plus puissants. Une étude expérimentale publiée en 2025 a ainsi observé, sur le matériel qu’elle a testé, que certains petits modèles locaux demandaient plus de trente secondes pour produire une réponse exploitable, contre moins de dix secondes pour les services cloud étudiés. Ces résultats ne s’appliquent pas à tous les téléphones ni à toutes les architectures, mais ils montrent que « local » n’est pas synonyme de rapidité universelle.
Les progrès des puces neuronales peuvent réduire cet écart. Les performances restent néanmoins très variables entre un téléphone haut de gamme récent et un appareil plus ancien ou moins puissant.
L’avantage décisif du fonctionnement hors ligne
Une IA réellement locale peut continuer à fonctionner dans un avion, dans une zone sans réseau ou lorsque les serveurs du fournisseur sont indisponibles.
Cet avantage dépasse le simple confort. Pour certaines professions, l’absence de connexion peut être une exigence de sécurité. Un technicien travaillant sur un site sensible, un professionnel manipulant des documents confidentiels ou un utilisateur situé dans une zone mal couverte peut avoir besoin d’outils indépendants d’un service distant.
Les fonctions adaptées sont généralement bien délimitées : transcription, traduction, correction, résumé de documents courts, recherche dans des notes ou classification d’images.
Le fonctionnement hors ligne a toutefois une limite évidente : le modèle ne peut pas consulter spontanément des informations récentes. Il peut traiter les données stockées sur l’appareil, mais pas connaître un événement survenu après sa dernière mise à jour sans accéder à une source externe.
Les petits modèles restent moins capables
Faire fonctionner une IA générative sur un téléphone impose de fortes contraintes de mémoire, de stockage, de consommation électrique et de dissipation thermique.
Les modèles locaux sont donc généralement plus petits ou plus fortement compressés que ceux utilisés dans le cloud. Apple indiquait par exemple en 2026 que son modèle local principal comptait environ trois milliards de paramètres, tandis que son modèle local avancé utilisait une architecture de vingt milliards de paramètres n’en activant qu’une fraction selon la requête.
La taille ne détermine pas à elle seule la qualité, mais les modèles compacts disposent généralement de moins de capacité pour traiter de longues instructions, maintenir un contexte important ou effectuer un raisonnement complexe.
La différence apparaît directement dans les architectures commerciales. En 2026, le modèle Apple exécuté sur l’appareil proposait une fenêtre de contexte de 4 000 unités, contre 32 000 pour son modèle Private Cloud Compute, lequel ajoutait des capacités de raisonnement plus avancées.
La compression permet de réduire la mémoire et l’énergie nécessaires, mais elle peut également détériorer les résultats. Des travaux expérimentaux ont mesuré des gains substantiels de vitesse et de consommation grâce à la quantification, tout en observant une baisse de précision sur certaines tâches complexes, notamment le raisonnement mathématique.
Les petits modèles sont donc efficaces lorsque la tâche est étroite et bien encadrée. Ils sont moins fiables pour analyser un dossier volumineux, comparer de nombreuses sources, écrire un programme complexe ou résoudre un problème nécessitant plusieurs étapes de raisonnement.
Une étude de cas publiée en 2026 sur l’intégration de petits modèles dans une application Android a relevé des erreurs de format, des violations de contraintes, des problèmes de latence et une dégradation lorsque le contexte s’allongeait. L’auteur a finalement réduit le rôle du modèle et ajouté des mécanismes déterministes de secours.
Le cloud peut-il rester confidentiel ?
Le cloud n’est pas nécessairement incompatible avec la protection de la vie privée, mais il élargit la chaîne de confiance.
Un fournisseur peut chiffrer les communications, limiter la conservation, séparer les données des comptes utilisateurs et empêcher l’utilisation des requêtes pour l’entraînement. La difficulté est que l’utilisateur doit croire ces engagements ou pouvoir les faire auditer.
Apple affirme que son infrastructure Private Cloud Compute ne conserve pas le contenu des requêtes, ne le rend pas accessible à l’entreprise et publie des éléments permettant à des chercheurs d’examiner les logiciels exécutés sur ses serveurs. L’appareil peut également produire un rapport indiquant quelles demandes ont été envoyées hors du terminal.
Cette approche réduit certains risques classiques du cloud. Elle ne rend toutefois pas le traitement identique à une exécution locale : les données quittent bien physiquement le téléphone et la sécurité dépend d’une architecture distante supplémentaire.
Le cloud confidentiel constitue donc un compromis, pas une équivalence parfaite.
Comment vérifier si une IA mobile protège réellement vos données
La première question à poser n’est pas « Le modèle est-il installé sur le téléphone ? », mais « La fonction que j’utilise est-elle entièrement exécutée localement ? ».
Il faut ensuite vérifier si l’application fonctionne en mode avion, si elle indique clairement les basculements vers le cloud, si l’historique est synchronisé et si les données servent à l’analyse ou à l’amélioration du service.
Les permissions demandées doivent également être proportionnées. Une fonction de correction de texte n’a pas nécessairement besoin d’accéder aux contacts, à la position ou à l’ensemble des photos.
Pour les informations sensibles, l’utilisateur devrait enfin pouvoir désactiver tout traitement distant et supprimer les historiques locaux. Une mention vague comme « alimenté par une IA embarquée » ne suffit pas à établir ces garanties.
Une meilleure confidentialité, sous conditions
Une IA entièrement exécutée sur le téléphone protège généralement mieux la vie privée qu’un service cloud conventionnel. Elle réduit les transferts, fonctionne hors ligne et limite le nombre d’acteurs ayant potentiellement accès aux informations.
Elle présente en contrepartie des limites de puissance, de mémoire, d’autonomie et de qualité. Elle peut aussi donner une illusion de sécurité lorsque l’application transmet des métadonnées, synchronise les résultats ou utilise automatiquement le cloud pour certaines demandes.
Le choix le plus pertinent n’est donc pas nécessairement de tout traiter localement. Une architecture hybride peut conserver sur l’appareil les données les plus sensibles et réserver le cloud aux tâches qui exigent davantage de puissance, à condition que ce partage soit transparent et contrôlable.
La véritable protection ne tient pas à un logo ou à une expression commerciale. Elle dépend d’une propriété vérifiable : la capacité de savoir précisément où chaque donnée est traitée et d’empêcher qu’elle quitte l’appareil lorsque cela n’est pas nécessaire.
