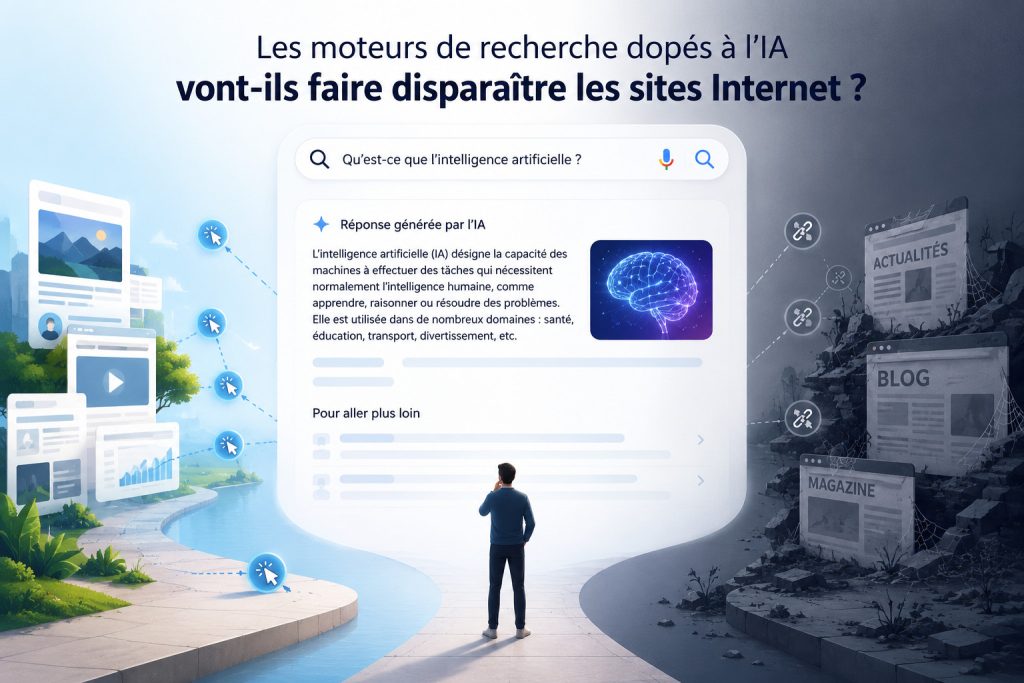
Pendant plus de vingt ans, le fonctionnement du Web a reposé sur un échange relativement simple. Les sites publiaient des informations accessibles aux moteurs de recherche. En contrepartie, ces moteurs leur envoyaient des visiteurs susceptibles de lire des articles, de voir des publicités, de souscrire un abonnement ou d’acheter un produit.
Les réponses générées par intelligence artificielle remettent en cause cet équilibre.
Au lieu de présenter uniquement une liste de liens, les moteurs peuvent désormais extraire plusieurs informations, les synthétiser et produire directement une réponse. L’utilisateur n’a plus nécessairement besoin de visiter les pages qui ont permis de construire cette réponse.
Cela ne signifie pas que les sites Internet vont disparaître. Mais certains risquent de perdre une part importante de leur audience, de leurs revenus et de leur influence. La menace ne concerne donc pas l’existence technique du Web : elle concerne son économie.
Du moteur de recherche au moteur de réponse
Un moteur de recherche traditionnel ne répondait pas directement à la plupart des questions. Il classait des pages et laissait l’utilisateur choisir la source qu’il souhaitait consulter.
Cette séparation s’est progressivement réduite avec les résultats enrichis, les cartes, les horaires, les prévisions météorologiques, les extraits optimisés et les réponses factuelles affichées directement dans la page de résultats. L’IA générative accélère fortement cette évolution : le moteur ne se contente plus d’extraire une phrase, mais peut composer une explication structurée à partir de plusieurs sources.
Google affirme qu’en mai 2026, ses AI Overviews comptaient plus de 2,5 milliards d’utilisateurs actifs mensuels et que son AI Mode avait dépassé le milliard d’utilisateurs mensuels. Ces chiffres sont ceux de l’entreprise et ne permettent pas, à eux seuls, de mesurer la satisfaction réelle ou les effets sur les éditeurs. Ils montrent néanmoins que la recherche conversationnelle n’est plus une expérimentation marginale.
Le changement est important : l’unité centrale de la recherche n’est plus nécessairement la page web, mais la réponse générée. Les liens restent présents, mais ils deviennent parfois des justificatifs secondaires plutôt que la destination principale du parcours.
Les réponses générées réduisent-elles réellement les clics ?
Les premières données indépendantes indiquent que le risque est réel.
Une étude du Pew Research Center portant sur les habitudes de navigation de 900 adultes américains en mars 2025 a constaté que les utilisateurs cliquaient sur un résultat classique dans 8 % des visites lorsqu’une synthèse générée par IA était affichée, contre 15 % lorsqu’aucune synthèse n’apparaissait. Les liens intégrés directement dans les réponses générées n’étaient eux-mêmes sélectionnés que dans environ 1 % des visites.
Ces résultats ne prouvent pas que chaque site perdra la moitié de son trafic. L’étude porte sur une période, un marché et un échantillon particuliers. Les effets varient selon le type de requête, la position des liens, la notoriété des sources et l’intention de l’utilisateur.
Ils invalident néanmoins une affirmation fréquemment avancée par les plateformes : ajouter des liens dans une réponse ne garantit pas que les internautes les consulteront.
Une étude universitaire publiée en 2026 a tenté de mesurer plus directement l’effet des AI Overviews sur Wikipédia. En comparant plus de 161 000 couples d’articles dans différentes langues, ses auteurs estiment que l’exposition aux résumés de Google a réduit d’environ 15 % le trafic quotidien des pages anglophones concernées. La baisse était plus importante pour les sujets culturels que pour les domaines scientifiques et techniques, vraisemblablement parce qu’une réponse courte suffit plus souvent à satisfaire les premières recherches. Ce travail constitue une étude préliminaire et non une vérité universelle, mais il fournit un indice causal plus solide qu’une simple corrélation de trafic.
Google présente une lecture différente. L’entreprise affirme que ses fonctions d’IA font découvrir une plus grande diversité de sites, génèrent des recherches plus complexes et peuvent produire des visites de meilleure qualité. Elle ne publie toutefois pas, dans les documents cités, de données suffisamment détaillées pour comparer indépendamment les clics générés et les clics perdus selon les catégories d’éditeurs.
La conclusion raisonnable est donc la suivante : les réponses générées ne suppriment pas tous les clics, mais elles réduisent probablement ceux qui reposaient sur des besoins informationnels simples.
Tous les sites ne sont pas exposés de la même manière
Les contenus les plus vulnérables sont ceux dont la valeur peut être condensée en quelques paragraphes : définitions, résumés, listes génériques, procédures simples, comparaisons superficielles ou réponses factuelles facilement recomposables.
Un article intitulé « Qu’est-ce qu’un VPN ? » risque davantage d’être remplacé par une synthèse qu’une enquête originale sur les pratiques d’un fournisseur de VPN. Une liste générique de conseils pour économiser de l’énergie est plus facilement absorbée qu’un calculateur personnalisé reposant sur les données d’un logement.
Cette distinction est décisive pour les blogs et les sites affiliés. Une grande partie de leur croissance reposait sur des pages conçues pour répondre exactement à des requêtes recherchées sur Google. Si le moteur fournit lui-même une réponse suffisante, le classement en première position conserve une valeur de visibilité, mais ne garantit plus l’audience.
Les sites qui republient des informations disponibles ailleurs sans expertise propre sont donc les plus menacés. L’IA réduit la valeur économique de l’intermédiation éditoriale faible.
À l’inverse, les contenus fondés sur une expérience directe, des données exclusives, des tests reproductibles, des documents originaux, une expertise reconnue ou un accès particulier restent beaucoup plus difficiles à remplacer. L’IA peut les résumer, mais elle ne peut pas produire rétroactivement l’enquête, l’expérience ou la preuve qui leur donne leur valeur.
Pourquoi cette évolution menace particulièrement les médias
Pour un média financé par la publicité, chaque visite perdue peut représenter moins d’impressions publicitaires. Pour un titre par abonnement, elle signifie moins d’occasions de convertir un lecteur. Pour un créateur indépendant, elle peut réduire les ventes, les dons, les inscriptions à une newsletter ou les revenus d’affiliation.
Le problème est asymétrique. La plateforme peut utiliser l’information publiée pour améliorer sa réponse tout en conservant l’utilisateur dans son propre environnement. L’éditeur supporte les coûts de production — journalistes, experts, déplacements, tests, hébergement ou vérification — mais ne reçoit pas nécessairement la visite qui permettait de les financer.
Une étude de grande ampleur menée sur plus de 55 000 requêtes au printemps 2026 a également relevé que 11 % des affirmations contenues dans les AI Overviews examinés n’étaient pas étayées par les pages citées. Les auteurs ont observé que plus de la moitié des pages citées affichaient de la publicité : lorsque le moteur synthétise leur contenu sans générer de clic, il peut donc capter l’attention tout en laissant les coûts de publication à la source. Cette recherche est récente et devra être reproduite, mais elle montre que citation, fidélité et rémunération sont trois problèmes distincts.
À long terme, cette situation crée un paradoxe. Les moteurs d’IA ont besoin d’un Web régulièrement alimenté par des contenus fiables. Mais s’ils réduisent excessivement les revenus de ceux qui produisent ces contenus, ils affaiblissent leurs propres sources futures.
Les sites Internet restent néanmoins indispensables
Une réponse générée ne constitue pas toujours une destination suffisante.
Les internautes auront encore besoin de sites pour acheter un produit, effectuer une réservation, consulter un dossier complet, vérifier un document, utiliser un outil, regarder une vidéo originale, participer à une communauté ou contacter une organisation.
Les sites remplissent également une fonction de preuve. Une synthèse peut affirmer qu’une entreprise propose une garantie de cinq ans, mais seul le contrat publié par l’entreprise permet d’en vérifier précisément les conditions. Une IA peut résumer une étude médicale, mais la publication originale reste nécessaire pour examiner la méthodologie, les limites et les données.
Le Web est en outre un espace que les éditeurs peuvent posséder et contrôler. Un site permet de construire une relation directe avec une audience, contrairement à une présence dépendant exclusivement d’un moteur, d’un réseau social ou d’un chatbot.
La disparition totale des sites créerait enfin un problème logique : les systèmes de recherche auraient de moins en moins de sources nouvelles à indexer. L’IA peut réorganiser les connaissances existantes, mais elle ne remplace pas automatiquement la collecte de données, le reportage, la recherche scientifique, le test de produits ou la création artistique.
Les sites ne disparaîtront donc pas. En revanche, une partie du Web conçu uniquement pour attirer des recherches génériques pourrait devenir économiquement inviable.
Vers un Web consulté par les machines plutôt que par les humains ?
Une autre transformation est possible : certains sites continueront d’exister, mais seront davantage consultés par des robots que par des lecteurs.
Les agents et moteurs d’IA pourront parcourir les pages, extraire les prix, comparer les conditions ou récupérer des informations pour répondre à l’utilisateur. Le site deviendra alors une infrastructure de données en arrière-plan.
Cette perspective soulève la question de la contrepartie. Pourquoi un éditeur autoriserait-il l’extraction massive de son contenu si elle ne lui apporte ni audience, ni rémunération, ni attribution significative ?
Les rapports de force commencent à évoluer. Cloudflare propose désormais aux propriétaires de sites des outils permettant de différencier les robots utilisés pour la recherche, l’entraînement ou les agents autonomes. Au Royaume-Uni, l’autorité de la concurrence a également obtenu en juin 2026 de nouveaux engagements destinés à permettre aux éditeurs de mieux contrôler l’utilisation de leurs contenus dans certaines fonctionnalités d’IA de Google et à renforcer leur attribution. Ces mesures ne règlent pas le modèle économique mondial, mais elles montrent que l’accès automatique au contenu ne sera pas nécessairement considéré comme gratuit et illimité.
Comment les éditeurs peuvent-ils s’adapter ?
La première erreur serait de chercher uniquement à optimiser des textes pour être cités par les IA. Une citation sans clic peut apporter de la notoriété, mais elle ne finance pas nécessairement la production.
Les éditeurs doivent augmenter la part de leur contenu que les moteurs ne peuvent pas reproduire sans perte majeure : enquêtes, tests documentés, données propriétaires, outils interactifs, expertise identifiable, opinions argumentées et communautés actives.
Ils doivent aussi réduire leur dépendance à une seule source d’audience. Les newsletters, les abonnements directs, les applications, les événements, les communautés et les recherches de marque permettent de conserver une relation avec les lecteurs sans attendre qu’un algorithme décide de leur envoyer du trafic.
Enfin, il faudra mesurer autre chose que les visites. Une marque peut être citée dans une réponse générée sans recevoir immédiatement de clic. Elle doit donc surveiller sa visibilité dans les moteurs d’IA, mais aussi vérifier si cette présence produit des recherches de marque, des inscriptions, des ventes ou une autorité réelle.
Une disparition partielle, mais surtout une redistribution du pouvoir
Les moteurs dopés à l’IA ne feront probablement pas disparaître les sites Internet. Ils peuvent en revanche faire disparaître une partie de leur trafic et, avec lui, certains modèles économiques.
Les sites les plus interchangeables — ceux qui reformulent des informations déjà disponibles sans produire de valeur propre — sont directement exposés. Les médias, blogs et créateurs capables de produire des informations originales resteront nécessaires, mais ils devront trouver des moyens plus directs de financer leur travail.
Le risque principal n’est donc pas un monde sans sites. C’est un Web dans lequel les sites continuent de supporter le coût de la connaissance tandis que les grandes interfaces d’IA captent l’attention, la relation avec l’utilisateur et une part croissante des revenus.
La question décisive n’est plus seulement : « Comment apparaître dans les résultats ? »
Elle devient : « Comment rester indispensable même lorsque l’utilisateur ne clique plus ? »
